Continuidad de planos
Vídeo con IA de primer a último fotograma: transiciones generativas en el lienzo
Comprende el funcionamiento de las transiciones generativas entre el fotograma inicial y final, evita deformaciones visuales, redacta prompts de movimiento y encadena planos en el lienzo de Say Action.
En esta página
- Interpolación frente a transiciones generativas: aclaración del mecanismo central
- El contrato visual entre el fotograma A y el fotograma B
- Encadenamiento de secuencias de planos en el lienzo de Say Action
- Cómo redactar el prompt de movimiento entre dos anclas visuales
- Detección de deformaciones y gestión del presupuesto en reintentos
- Conecta tus propias API y servicios de intermediación
Interpolación frente a transiciones generativas: aclaración del mecanismo central
Muchos creadores que se inician en la producción audiovisual con IA confunden la interpolación de fotogramas tradicional con las transiciones generativas de primer a último fotograma (FLF2V, First/Last Frame to Video). Los algoritmos de interpolación clásicos, basados en flujo óptico o modelos profundos como RIFE o FILM, trabajan sobre secuencias de vídeo ya grabadas. Su único cometido consiste en sintetizar fotogramas intermedios en intervalos de milisegundos para aumentar la fluidez (por ejemplo, convertir 24 fps a 60 fps o generar cámara lenta) siguiendo vectores de píxeles preexistentes. Por el contrario, la generación de vídeo a partir de fotograma inicial y final parte de dos imágenes conceptuales completamente estáticas: el fotograma A y el fotograma B. El modelo de difusión no se limita a suavizar píxeles; debe interpretar en el espacio latente la profundidad tridimensional, la cinemática esquelética y la física del entorno para crear desde cero varios segundos de narrativa visual coherente.
Entender esta diferencia es fundamental para evitar fallos graves al estructurar los planos de una microserie. Si tratas la generación con IA como una simple herramienta mecánica de interpolación, obtendrás deformaciones visuales inaceptables. Cuando el modelo de difusión recibe el fotograma A y el fotograma B, busca una trayectoria continua en el espacio latente que satisfaga ambas condiciones de contorno. Si la distancia compositiva o postural entre ambos extremos es excesiva para la capacidad del modelo, la red no puede calcular un recorrido compatible con la física real. En lugar de mostrar a un personaje girando con naturalidad, el modelo recurre a estiramientos grotescos, extremidades duplicadas o rostros que se derriten (melting artifacts). Planificar una transición generativa exige criterio de dirección: el fotograma A y el fotograma B deben concebirse como los puntos de inicio y final de una misma acción cinematográfica continua.
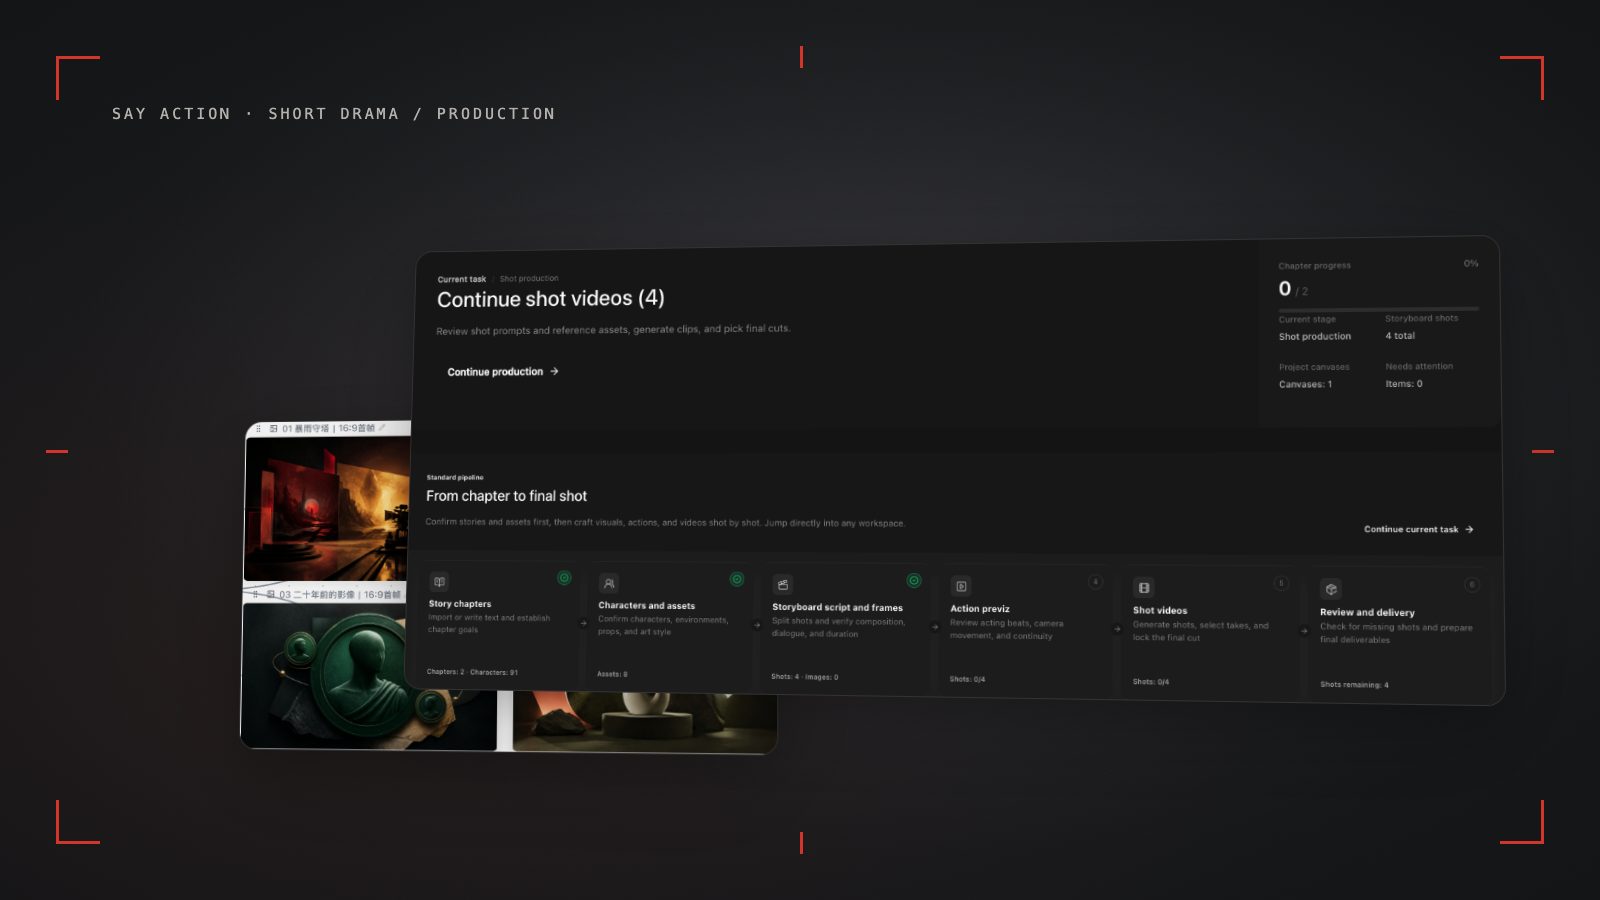
En un flujo de producción industrial, las transiciones generativas unen el storyboard estático con el material en movimiento listo para montaje. Frente a la generación a ciegas a partir de texto, donde el encuadre final queda al azar, el anclaje dual proporciona un control riguroso sobre la entrada y la salida de cámara. En el lienzo de Say Action, este mecanismo se integra directamente al desglosar el guion en filas de planos y conectarlas a nodos de vídeo. Al fijar lo que la cámara ve al comenzar la toma y bloquear la composición exacta con la que debe terminar, se elimina la deriva acumulativa de encuadre y se obtienen clips que encajan de forma natural en la línea de tiempo externa.
El contrato visual entre el fotograma A y el fotograma B
Para que una transición generativa funcione sin deformaciones grotescas, el fotograma A y el fotograma B deben respetar lo que en cinematografía se denomina contrato de continuidad visual. Dado que los modelos de difusión resuelven trayectorias vectoriales en el espacio latente, todas las constantes físicas del entorno deben ser coherentes entre ambas imágenes. El primer pilar de este contrato es la geometría de la iluminación: la dirección de la luz principal, la intensidad de relleno, la temperatura de color y las sombras deben coincidir. Si el fotograma A muestra una iluminación cálida de atardecer lateral y el fotograma B presenta luz cenital fluorescente y fría, el modelo no podrá deducir una transición verosímil y generará parpadeos cromáticos o artefactos extraños.
El segundo pilar es la coherencia anatómica, de vestuario y de decorado. El peinado, el tejido de la ropa, los accesorios, los rasgos faciales y la arquitectura del fondo deben estar perfectamente alineados en ambos fotogramas. Si el protagonista viste una gabardina desabrochada en el fotograma A, no puede aparecer con ella abotonada en el fotograma B a menos que el prompt describa específicamente dicha acción y haya tiempo suficiente para realizarla. Asimismo, la distancia focal y la perspectiva no deben sufrir cambios bruscos. Pasar de un gran angular de 24 mm en A a un teleobjetivo de 85 mm en B provoca distorsiones de perspectiva incontrolables. Conviene preparar ambos fotogramas en el lienzo mediante nodos de referencia de personaje y estilos maestros antes de conectarlos a un nodo de vídeo.
El tercer requisito es la adecuación entre el desplazamiento físico y la duración en segundos del plano. En la vida real, un personaje sentado ante un escritorio no puede levantarse, cruzar una estancia de cinco metros y abrir una puerta en un lapso de solo tres segundos. Exigir un movimiento excesivo en pocos fotogramas obliga al modelo a acelerar la cinemática a velocidades antinaturales, produciendo brazos de goma y rostros borrosos. Aplica la regla de la acción única: el fotograma A establece el inicio de un gesto concreto (por ejemplo, acercar la mano a una taza) y el fotograma B muestra el final de ese mismo gesto (la taza en los labios). Si la escena incluye varias acciones complejas, desglósala en subplanos sucesivos en lugar de sobrecargar una sola transición.
Encadenamiento de secuencias de planos en el lienzo de Say Action
En una producción con múltiples planos consecutivos, lograr transiciones fluidas requiere un espacio donde los recursos visuales pasen de una toma a otra sin fricción. En el lienzo de Say Action, esta continuidad se gestiona mediante el encadenamiento visual de nodos (Node Chaining). En lugar de exportar archivos de vídeo, capturar fotogramas finales en programas externos y volver a subirlos, todo el flujo se resuelve directamente sobre el lienzo infinito. Empiezas conectando una fila del storyboard a un nodo de fotograma clave (inicio) y a un nodo de generación de vídeo (como Seedance 2.5). Una vez renderizado el plano 1 y validada la cámara, puedes extraer su punto de cierre exacto sin salir del proyecto.
El procedimiento para extraer el fotograma final es sumamente sencillo. En el reproductor del nodo de vídeo del plano 1, abre el menú de opciones situado en la esquina superior derecha y selecciona «Extraer último fotograma» (Extract Last Frame). El sistema captura el fotograma final en su resolución nativa y lo convierte al instante en un nuevo nodo de imagen independiente en el lienzo. Este nuevo nodo pasa a ser una referencia visual clave para el plano 2. Al conectar la salida de esta imagen con la casilla «First Frame» (primer fotograma) del nodo de vídeo del plano 2, utilizar el último fotograma del plano anterior como inicio del siguiente mejora enormemente la continuidad visual y reduce saltos en vestuario, iluminación o posición; no obstante, el resultado final depende del modelo de vídeo utilizado y requiere siempre revisión.
Conviene tener en cuenta que no todos los modelos de vídeo ni todos los adaptadores admiten las mismas ranuras de entrada. Por ejemplo, los canales de Seedance admiten de forma nativa fotograma inicial y fotograma final simultáneos, lo que resulta ideal para transiciones con inicio y cierre bloqueados. En cambio, los adaptadores actuales de Gemini Veo o Novita solo aceptan una imagen de inicio, y MiniMax H3 prohíbe por API mezclar el modo de primer/último fotograma con imágenes de referencia adicionales. Al diseñar secuencias complejas en Say Action, reserva los modelos compatibles con anclaje dual para los planos de enlace riguroso y utiliza modelos de imagen única para planos de reacción o primeros planos libres.
Cómo redactar el prompt de movimiento entre dos anclas visuales
Cuando se genera un vídeo a partir de dos fotogramas clave, el prompt cumple una función muy distinta a la de la generación pura a partir de texto. El error más común entre principiantes es volver a describir el decorado y los personajes, escribiendo frases como «un joven detective con gabardina beige en un callejón con niebla». Dado que el fotograma A y el fotograma B ya determinan el rostro, la ropa, la luz y el fondo al milímetro, reiterar descripciones estáticas solo dispersa la atención del codificador de texto y resta fuerza al condicionamiento visual. En una transición de primer a último fotograma, el prompt debe actuar estrictamente como un «puente de movimiento» (Motion Bridge) que describa la trayectoria física de A hacia B.
Un prompt de puente de movimiento eficaz se compone de tres elementos estructurados: vector de cámara, acción del sujeto y dinámica secundaria ambiental. La fórmula de dirección recomendada es: `[Cámara: vector y velocidad] + [Sujeto: acción de transición concreta] + [Entorno: sutil movimiento ambiental]`. Por ejemplo, si el fotograma A es un plano medio de un directivo mirando el móvil y el fotograma B es un plano sobre el hombro que encuadra la pantalla encendida, el prompt óptimo sería: «La cámara avanza en travelling frontal suave y constante, elevándose ligeramente hacia el hombro derecho del sujeto. El sujeto inclina la mirada y orienta el móvil hacia la lente. La luz de la pantalla ilumina tenuemente la barbilla, movimiento cinematográfico fluido y sin vibraciones». Se prescinde de describir al actor y se define con precisión el recorrido espacial.
Los términos relativos al ritmo y la velocidad influyen de forma decisiva en el resultado. Conviene añadir expresiones de estabilización como «velocidad constante» (steady velocity), «desaceleración suave» (smooth easing) o «enfoque bloqueado en el sujeto». Por el contrario, directrices caóticas como «movimiento brusco de cámara y giro rápido» inducen momentos rotacionales excesivos que deforman los rasgos faciales en los fotogramas intermedios. Si la escena requiere dinamismo, utiliza terminología cinematográfica estándar (como Dolly-In, Pedestal o Orbit Arc) para trazar una guía limpia que el modelo pueda seguir sin perder el control anatómico.
Detección de deformaciones y gestión del presupuesto en reintentos
Incluso con prompts precisos y fotogramas bien escogidos, las transiciones generativas pueden arrojar fallos en ocasiones. El defecto más característico es la deformación por fusión en el espacio latente (morphing): el sujeto se mantiene estable al principio y al final, pero en la parte intermedia del clip sus facciones o sus manos sufren distorsiones antinaturales antes de recomponerse en el último segundo. Esto sucede cuando la distancia matemática entre el ancla A y el ancla B supera el límite de atención espaciotemporal del modelo. Al revisar los clips en el lienzo, examina siempre los fotogramas de la zona intermedia; si observas dedos duplicados, ojos desalineados o texturas flotantes, la transición ha sobrepasado su capacidad física.
Para corregir estas deformaciones de forma metódica, sigue este protocolo en tres pasos. Primero, comprueba la duración del nodo de vídeo: ampliar el tiempo de 3 o 4 segundos a 5 o 6 segundos suele proporcionar el margen temporal necesario para que el modelo calcule una trayectoria suave. Segundo, revisa el ángulo de rotación corporal entre A y B; si el personaje gira más de 90 grados o recorre un espacio profundo, divide la fila del storyboard en dos subplanos insertando un fotograma intermedio (de A a A.5 y de A.5 a B). Tercero, verifica que no existan vectores ambientales contradictorios, como cortinas movidas por el viento hacia la izquierda en A mientras el prompt pide movimiento hacia la derecha.
Durante la producción de una serie corta, mantener bajo control los créditos y los reintentos resulta imprescindible. Cuando surgen incidencias técnicas con los servicios de upstream, Say Action protege los saldos de los creadores: Si el proveedor confirma que la generación ha fallado, se devuelven los créditos reservados. Si se pierde la conexión y no se puede confirmar el resultado o el coste, la tarea queda pendiente de revisión para evitar cargos o devoluciones duplicados. Por el contrario, si el vídeo se genera correctamente pero el movimiento no convence a nivel de dirección, repetirlo constituye una nueva tarea con estimación previa de créditos en pantalla. Para evitar gastos innecesarios, no lances pruebas de 10 segundos en transiciones arriesgadas; valida primero la coherencia con pasadas económicas de 4 segundos y reserva las duraciones largas para las tomas definitivas.
Conecta tus propias API y servicios de intermediación
En los ajustes del canal, introduce la Base URL y la clave API. Configura el protocolo, los identificadores de modelo y las cabeceras siguiendo la documentación del proveedor. Comprueba los modos de imagen y vídeo antes de generar. Las rutas, resoluciones y entradas de fotograma inicial y final dependen del canal. Solicitar la adaptación de un servicio no garantiza su compatibilidad.
BYOK permite configurar la dirección de la API, la clave del modelo y cabeceras personalizadas. Con OneAPI, NewAPI u otro intermediario, elige el protocolo OpenAI, Gemini o Claude que corresponda a su API y comprueba los identificadores de modelo y la compatibilidad de las API de imagen y vídeo. No todos los servicios o protocolos privados funcionan automáticamente. Las llamadas BYOK no tienen recargo de plataforma ni consumen créditos de generación de la plataforma; el espacio de trabajo y el uso del proveedor se cobran por separado.
Conecta solo proveedores de confianza y utiliza HTTPS en producción. Las solicitudes pasan por el servidor con autenticación e incluyen los prompts, las referencias y las credenciales necesarios. No incluyas claves API, contraseñas ni cabeceras con secretos en lienzos públicos, capturas de pantalla o solicitudes de soporte.
Preguntas frecuentes
¿Se puede hacer una transición entre dos escenas totalmente distintas usando primer y último fotograma?
En el vídeo con IA generativa, suministrar dos fotogramas con iluminación, personajes o entornos completamente diferentes provoca que el modelo genere un efecto de fusión deforme (morphing) muy caótico en los fotogramas centrales. Aunque puede buscarse como efecto artístico en videoclips abstractos, en una microserie narrativa rompe la credibilidad de la historia. Para cambios de escena o saltos temporales, lo profesional es recurrir a cortes directos tradicionales, cortes de barrido con elementos que tapen el plano o match cuts, en lugar de forzar una interpolación generativa entre espacios incompatibles.
¿Todos los modelos de vídeo en Say Action admiten fotograma final (Last Frame)?
No. Cada modelo y canal ascendente dispone de esquemas de parámetros y adaptadores diferentes. En el lienzo de Say Action, los canales de Seedance admiten de forma nativa fotograma inicial y fotograma final simultáneos, mientras que los adaptadores actuales de Gemini Veo o Novita solo aceptan una imagen inicial. Por su parte, MiniMax H3 prohíbe mezclar el modo de primer/último fotograma con imágenes de referencia de personajes. Antes de estructurar una secuencia, comprueba las ranuras disponibles en el nodo del modelo seleccionado.
¿Cómo se extrae el último fotograma de un vídeo generado en el lienzo de Say Action?
Una vez generado un clip satisfactorio en un nodo de vídeo, abre el menú de opciones situado en la esquina superior derecha del reproductor y pulsa «Extraer último fotograma» (Extract Last Frame). El sistema captura el fotograma de cierre a resolución completa y lo genera en el lienzo como un nuevo nodo de imagen independiente. A continuación, basta con enlazar este nodo a la ranura «First Frame» del siguiente nodo de vídeo para asegurar una continuidad visual perfecta.
¿Qué debo hacer si el movimiento entre el primer y el último fotograma se ve acelerado o deformado?
Cuando el movimiento parece precipitado o la anatomía se deforma, suele deberse a que la duración asignada al vídeo es insuficiente para el desplazamiento físico requerido entre ambas posturas. En los ajustes del nodo de vídeo, aumenta la duración (por ejemplo, pasando de 4 a 6 segundos) para dar margen al modelo y que resuelva la cinemática con suavidad. Si el problema persiste, la distancia entre posturas es excesiva; inserta un fotograma intermedio en el lienzo y divide la acción en dos planos más breves y naturales.
¿Puedo conectar OneAPI, NewAPI y cabeceras personalizadas?
BYOK permite configurar la dirección de la API, la clave del modelo y cabeceras personalizadas. Con OneAPI, NewAPI u otro intermediario, elige el protocolo OpenAI, Gemini o Claude que corresponda a su API y comprueba los identificadores de modelo y la compatibilidad de las API de imagen y vídeo. No todos los servicios o protocolos privados funcionan automáticamente. Las llamadas BYOK no tienen recargo de plataforma ni consumen créditos de generación de la plataforma; el espacio de trabajo y el uso del proveedor se cobran por separado.