Flujo de producción
Cómo rodar diálogos entre dos personajes con IA: planos sobre el hombro, eje de miradas y continuidad
Evita la fusión de identidades en vídeos de diálogo con IA mediante plano y contraplano, planos sobre el hombro (OTS), nodos independientes en el lienzo y la regla de los 180 grados.
En esta página
- Por qué poner dos caras en un mismo prompt falla: la trampa de la fusión de identidades
- La regla de cobertura en tres partes para diálogos con IA: planos sobre el hombro y contraplanos
- Construcción de nodos de personaje independientes en el lienzo de Say Action
- La regla de los 180 grados en storyboards verticales 9:16: bloqueo de miradas
- Exportación de clips y sincronización de diálogos en editores externos
- Conecta tus propias API y servicios de intermediación
Por qué poner dos caras en un mismo prompt falla: la trampa de la fusión de identidades
Quienes intentan rodar su primera escena de diálogo en vídeo generativo suelen escribir prompts ambiciosos con dos personajes a la vez: "Un hombre alto con traje gris marengo y una mujer pelirroja con vestido de seda esmeralda discutiendo intensamente frente a una mesa". En el espacio latente de los modelos de difusión de texto a vídeo, esta instrucción provoca casi siempre una grave "fusión de identidades" (o promediado de rasgos). Durante los pasos de reducción de ruido, las representaciones de ambos sujetos se contaminan mutuamente. En vez de dos actores diferenciados, el modelo produce dos figuras con rasgos faciales híbridos o personajes cuyo pelo y ropa mutan de un fotograma a otro.
El origen de este problema reside en cómo los mecanismos de atención cruzada (cross-attention) procesan atributos de múltiples sujetos sin cajas delimitadoras espaciales rígidas. Cuando un único prompt introduce a la vez "pelo del personaje A", "vestido del personaje B", mandíbula masculina y pómulos femeninos, los pesos de atención se reparten por todo el lienzo. En cuanto los personajes gesticulan o se mueven, el mapa de atención pierde precisión: el traje masculino absorbe texturas del vestido o la mujer hereda rasgos faciales masculinos. En una producción profesional, confiar en que un modelo mantenga dos identidades humanas perfectas en una sola toma continua no es una estrategia viable.
La solución técnica no consiste en acumular prompts negativos interminables ni en repetir generaciones al azar, sino en adaptar la cobertura cinematográfica tradicional a las herramientas generativas. En lugar de forzar dos caras en el mismo fotograma, el flujo de trabajo divide el diálogo en configuraciones de cámara dedicadas a un solo personaje: un plano general o medio de situación, seguido de planos sobre el hombro (OTS) alternados y primeros planos de reacción. Al asociar cada nodo de generación a la identidad de un solo actor principal, se aíslan los pesos del modelo y se elimina la mezcla de caras de raíz.
La regla de cobertura en tres partes para diálogos con IA: planos sobre el hombro y contraplanos
La cobertura dramática profesional divide cualquier conversación entre dos personajes en cuatro configuraciones de cámara que encajan a la perfección en un lienzo de storyboard con IA. El plano 1 es un plano mestre o medio de situación (Master Two-Shot) que define la distancia y el eje espacial; no busca microexpresiones hiperdetalladas, sino situar a ambos interlocutores. El plano 2 es un plano sobre el hombro (OTS) orientado hacia el personaje B, donde el foco y la referencia visual se asignan por completo a dicho personaje. El plano 3 invierte el ángulo en un contraplano centrado en el personaje A. El plano 4 aísla las emociones mediante primeros planos de reacción cerrados.
La técnica fundamental para clavar los planos 2 y 3 reside en cómo se describe el hombro desenfocado. Si el prompt indica literalmente "la espalda y el hombro del personaje A", el modelo de difusión suele alucinar fragmentos de ojos, orejas o mechones deformes en la nuca de la figura en primer término. La fórmula eficaz es tratarlo como un elemento puramente óptico: over-the-shoulder shot, out-of-focus dark foreground shoulder silhouette in lower corner, sharp focus on [Personaje B]. Al reducir la figura en primer término a una silueta oscura desenfocada, se ayuda al modelo a concentrarse en el rostro visible y nítido que está hablando.
El plano 4 (primer plano de reacción) es el recurso clave en las microseries verticales para móvil. El formato vertical 9:16 posee una fuerza de retrato insuperable en pantallas de teléfono. Un clip de dos segundos que muestre al personaje A tensando la mandíbula o tragando saliva ante una revelación evita la competencia de otros sujetos en el encuadre, lo que ayuda a mantener una mayor fidelidad y consistencia facial. Además, al montar la escena en un software de edición, los planos de reacción funcionan como amortiguadores narrativos que permiten encajar cortes de audio (cortes en L o J) y disimular desfases de continuidad.
| Tipo de plano | Encuadre y foco | Especificación de prompt | Vinculación de referencias |
|---|---|---|---|
| Plano general/medio (Master) | Plano medio hasta la cintura, ambos personajes visibles frente a frente | Cámara fija, a la altura de los ojos, iluminación neutra, distancia de diálogo | Sin fijar a un solo personaje; usar imagen de ambiente o prompt general |
| Plano sobre el hombro B (OTS) | Encuadre OTS, personaje B enfocado mirando hacia la izquierda | Mirada ligeramente a la izquierda; hombro del personaje A en silueta desenfocada | Conectar solo el nodo de referencia multiángulo del personaje B |
| Contraplano sobre el hombro A | Encuadre inverso OTS, personaje A enfocado mirando hacia la derecha | Mirada ligeramente a la derecha; hombro del personaje B en silueta desenfocada | Conectar solo el nodo de referencia multiángulo del personaje A |
| Primer plano de reacción | Primer plano cerrado de un solo actor reaccionando en formato vertical 9:16 | Microexpresión sutil al escuchar, cámara fija o avance dolly muy suave | Nodo de referencia de un solo actor junto a fotograma clave de alta resolución |
Basado en la vinculación de nodos de Say Action y la técnica clásica de plano y contraplano; verificado para vídeo vertical 9:16.
Construcción de nodos de personaje independientes en el lienzo de Say Action
Llevar este flujo de diálogo al lienzo infinito de Say Action exige organizar los nodos con criterio. En primer lugar, se crean dos nodos de referencia de personaje independientes: uno para el personaje A y otro para el personaje B. Cada nodo debe contener anclajes visuales confirmados, como un retrato frontal neutro (0°) y un ángulo de tres cuartos (45°) que muestre el pelo y la mandíbula. Estos fotogramas clave se pueden generar previamente en el lienzo con nodos de imagen (como Nano Banana) o subiendo bocetos autorizados. Mantener las referencias en nodos aislados garantiza que las descripciones y rostros no se crucen antes de renderizar el vídeo.
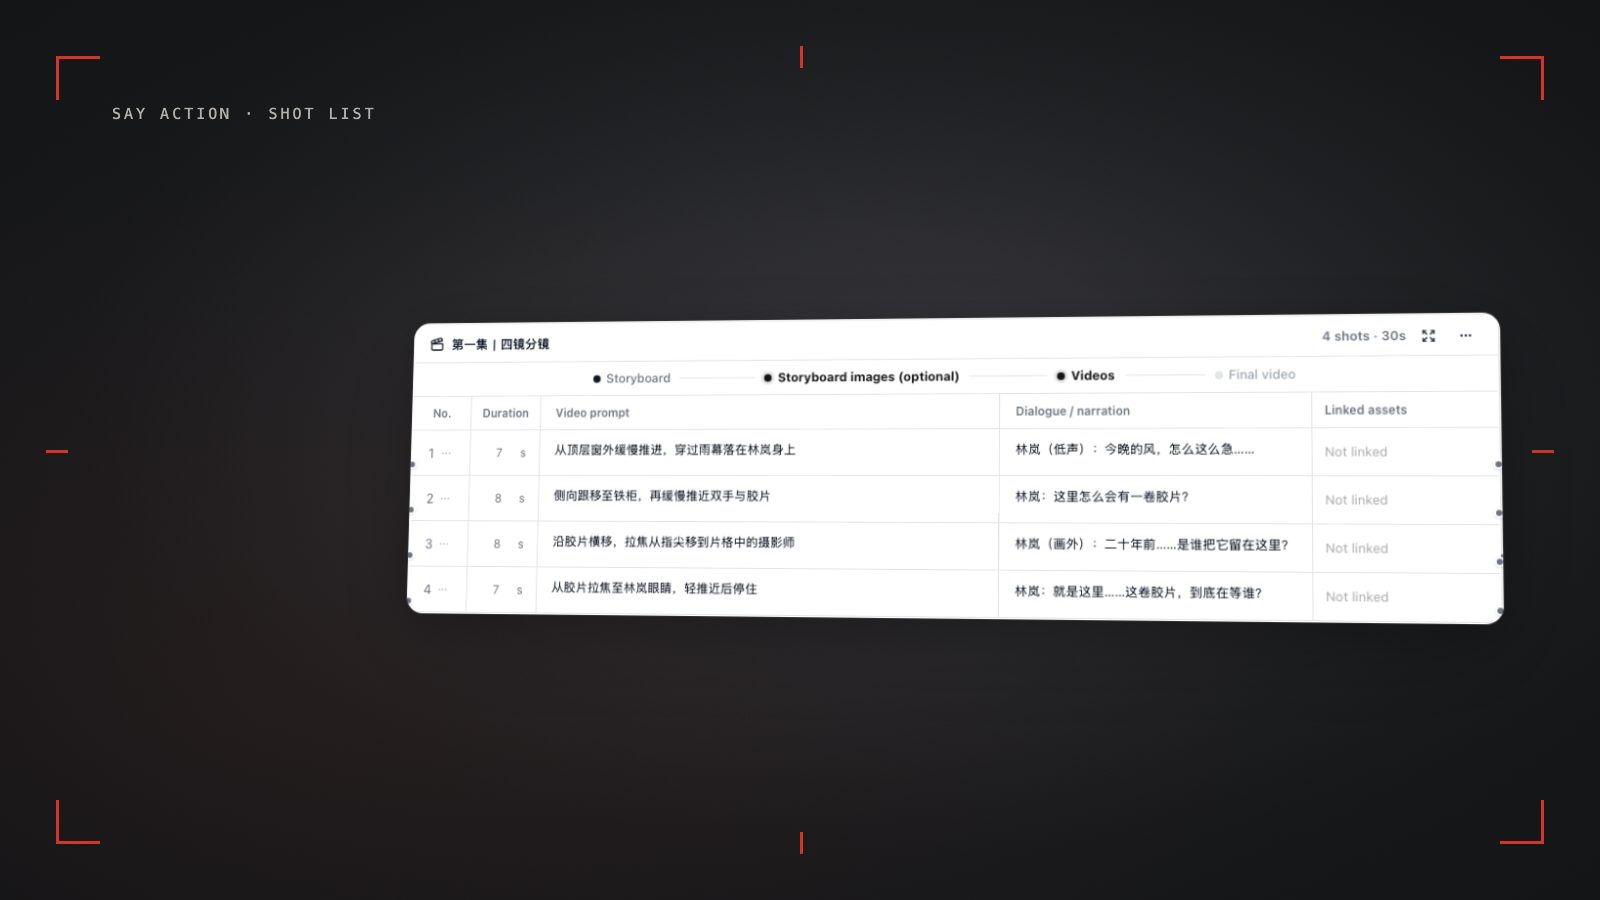
A continuación, el guion se convierte en una tabla de storyboard editable mediante el nodo de guion. La escena se divide en filas alternas según el esquema de cuatro planos. Para generar el vídeo de la fila 2 (plano 2: OTS sobre el personaje B), se traza una línea de conexión únicamente desde el nodo de referencia del personaje B hacia la entrada del nodo de vídeo, seleccionando un modelo como Seedance 2.5 o MiniMax H3. Para la fila 3 (plano 3: contraplano sobre el personaje A), se conecta exclusivamente el nodo del personaje A. La duración de cada plano debe mantenerse corta, entre 2 y 4 segundos, lo que evita deformaciones y permite afinar miradas y gestos.
Esta arquitectura desacoplada en el lienzo ofrece una gran seguridad y control del presupuesto. Si el plano 3 genera un movimiento de cabeza extraño, solo hay que modificar el prompt de movimiento de ese nodo concreto y volver a generarlo, sin alterar los planos 1, 2 o 4 ya aprobados. El gasto de créditos se calcula por toma según la resolución y duración elegidas, mostrando la estimación antes de confirmar. La facturación de la plataforma y las garantías de reembolso siguen los límites oficiales del producto: Si el proveedor confirma que la generación ha fallado, se devuelven los créditos reservados. Si se pierde la conexión y no se puede confirmar el resultado o el coste, la tarea queda pendiente de revisión para evitar cargos o devoluciones duplicados. Consulta los modelos, las resoluciones y los créditos estimados en la pantalla de creación. El cargo final se muestra antes de enviar la generación. La tarifa cubre el espacio de trabajo, no el consumo de modelos. La API del proveedor se paga aparte.
La regla de los 180 grados en storyboards verticales 9:16: bloqueo de miradas
En el cine panorámico tradicional, saltarse el eje de acción de 180 grados provoca desorientación espacial; en el formato vertical 9:16, ese fallo resulta aún más dañino. Como la pantalla del móvil es estrecha, los personajes quedan encuadrados muy juntos y el espectador depende por completo de la dirección de la mirada para entender quién habla con quién. Si en el plano 2 el personaje A mira hacia la derecha y en el plano 3 el personaje B también mira hacia la derecha, la sensación de diálogo se rompe: parece que ambos miran hacia el mismo lado en vez de mirarse a los ojos.
Para asegurar miradas coherentes entre tomas generativas, es imprescindible fijar la dirección de los ojos en cada fila del storyboard. Se traza la línea imaginaria a un lado de la conversación y todas las cámaras se sitúan en ese mismo semicírculo. En la tabla de Say Action, conviene estandarizar los prompts: para el personaje A, eye level, facing screen-right, gaze directed slightly right of camera toward off-screen listener; para el personaje B, eye level, facing screen-left, gaze directed slightly left of camera toward off-screen speaker. Indicar que la mirada vaya ligeramente ladeada respecto al objetivo en vez de un perfil a 90 grados permite captar las expresiones faciales sin perder la geometría del diálogo.
Igual de importante es la disciplina en el movimiento de cámara. En secuencias de acción, los desplazamientos rápidos pueden lucir bien, pero en un diálogo una cámara virtual errática destruye las referencias espaciales. Conviene evitar prompts con "órbita alrededor del sujeto" o "paneo rápido" en planos OTS, ya que los modelos de difusión suelen invertir las coordenadas de la pantalla a mitad de la toma. Lo recomendable es ceñirse a movimientos sobrios: cámara fija sobre trípode (locked-off tripod shot) o un avance muy suave (slow subtle dolly-in, 0.5x speed) que sume tensión dramática sin descolocar el eje.
Exportación de clips y sincronización de diálogos en editores externos
Una vez generados todos los planos de diálogo en el lienzo de Say Action, el paso a posproducción requiere una gestión ordenada de los archivos. Con las funciones de guardado local de Say Action, los clips MP4 generados se exportan directamente a una carpeta estructurada en el disco local. Se recomienda seguir una nomenclatura rigurosa: Scene03_Shot01_Master, Scene03_Shot02_OTS_CharB, Scene03_Shot03_Reverse_CharA y Scene03_Shot04_Reaction_CharA. Esta organización facilita la importación en editores como CapCut, Premiere o DaVinci Resolve sin riesgo de perder enlaces ni confundir planos.
En la línea de tiempo del editor, el montaje se apoya en cortes en J y en L. En lugar de cortar imagen y sonido de golpe al mismo tiempo, la voz del personaje A puede comenzar medio segundo antes de mostrar su rostro, o prolongarse sobre el plano de reacción del personaje B. En el drama vertical para móvil, un ritmo ágil con cortes cada 1,5 o 3 segundos mantiene alta la retención de la audiencia. Los planos de reacción son el salvavidas ideal: si un clip con IA presenta un final de frase con un movimiento de boca dudoso, basta con pasar la imagen a la reacción del oyente mientras el audio termina con total naturalidad.
Por último, conviene separar la generación visual de la sincronización de audio definitiva. Say Action se centra en el desglose del guion, los fotogramas clave y la generación de vídeo con diversos modelos; la sincronización de voz final se remata en el montaje integrando pistas de doblaje o herramientas externas de sincronización labial. Si el montador detecta que a una toma le falta fuerza dramática o que la mirada se desvía, no hace falta rehacer la escena entera: basta con regresar al nodo correspondiente en Say Action, ajustar el prompt, generar un nuevo clip de sustitución y colocarlo directamente en la línea de tiempo.
Conecta tus propias API y servicios de intermediación
En los ajustes del canal, introduce la Base URL y la clave API. Configura el protocolo, los identificadores de modelo y las cabeceras siguiendo la documentación del proveedor. Comprueba los modos de imagen y vídeo antes de generar. Las rutas, resoluciones y entradas de fotograma inicial y final dependen del canal. Solicitar la adaptación de un servicio no garantiza su compatibilidad.
BYOK permite configurar la dirección de la API, la clave del modelo y cabeceras personalizadas. Con OneAPI, NewAPI u otro intermediario, elige el protocolo OpenAI, Gemini o Claude que corresponda a su API y comprueba los identificadores de modelo y la compatibilidad de las API de imagen y vídeo. No todos los servicios o protocolos privados funcionan automáticamente. Las llamadas BYOK no tienen recargo de plataforma ni consumen créditos de generación de la plataforma; el espacio de trabajo y el uso del proveedor se cobran por separado.
Conecta solo proveedores de confianza y utiliza HTTPS en producción. Las solicitudes pasan por el servidor con autenticación e incluyen los prompts, las referencias y las credenciales necesarios. No incluyas claves API, contraseñas ni cabeceras con secretos en lienzos públicos, capturas de pantalla o solicitudes de soporte.
Preguntas frecuentes
¿Se puede generar a dos personas conversando de forma continua en un solo clip de 15 segundos?
No se recomienda en absoluto. Intentar mantener a dos personajes interactuando en una toma larga provoca graves deformaciones faciales y mezcla de identidades. La práctica profesional consiste en dividir el diálogo en tomas de 2 a 4 segundos de un solo personaje (plano y contraplano) y unirlas en edición.
¿Cómo evitar que el hombro desenfocado en un plano OTS se deforme o genere extremidades extra?
Define en el prompt la figura en primer término estrictamente como un elemento óptico, por ejemplo "blurred dark foreground shoulder out of focus in corner". Al describirlo como una silueta oscura desenfocada, el modelo no intentará dibujar rostros o miembros innecesarios sobre ella.
¿Qué hacer si la IA invierte la dirección de las miradas entre planos?
Especifica la dirección exacta de la mirada en la columna de prompts del storyboard (por ejemplo, "eye level, facing screen-right toward conversational partner"). Si una toma sale con la mirada cambiada, basta con regenerar ese nodo de vídeo individual en el lienzo sin tocar el resto.
¿Say Action sincroniza automáticamente los labios de los personajes con la voz?
Say Action está pensado para el desglose de guiones, la gestión de storyboards, los fotogramas clave y la generación de vídeo con diversos modelos. La sincronización de voz y labios final se realiza exportando los clips a un editor (como CapCut o Premiere) con las pistas de audio o mediante herramientas de lip-sync dedicadas.
¿Puedo conectar OneAPI, NewAPI y cabeceras personalizadas?
BYOK permite configurar la dirección de la API, la clave del modelo y cabeceras personalizadas. Con OneAPI, NewAPI u otro intermediario, elige el protocolo OpenAI, Gemini o Claude que corresponda a su API y comprueba los identificadores de modelo y la compatibilidad de las API de imagen y vídeo. No todos los servicios o protocolos privados funcionan automáticamente. Las llamadas BYOK no tienen recargo de plataforma ni consumen créditos de generación de la plataforma; el espacio de trabajo y el uso del proveedor se cobran por separado.