Fluxo de produção
Como criar diálogos com múltiplos personagens em vídeo IA: planos sobre o ombro e continuidade
Elimine a fusão de rostos em diálogos gerados por IA com decupagem clássica de plano e contraplano, planos sobre o ombro (OTS), nós separados no canvas e fixação da linha do olhar em 180 graus.
Nesta página
- Por que colocar dois rostos no mesmo prompt falha: a armadilha da fusão de identidades
- A regra de decupagem em três partes para diálogos com IA: planos sobre o ombro e contraplanos
- Construção de nós de personagem independentes no canvas da Say Action
- A regra dos 180 graus em storyboards verticais 9:16: fixando as linhas de olhar
- Exportação de clipes e sincronização de diálogos em editores externos
- Conecte suas APIs e serviços de intermediação
Por que colocar dois rostos no mesmo prompt falha: a armadilha da fusão de identidades
Ao tentar produzir a primeira cena de diálogo em vídeo generativo, muitos criadores escrevem prompts ambiciosos com dois personagens juntos: "Um homem alto de terno cinza-chumbo e uma mulher ruiva com vestido de seda verde-esmeralda discutindo intensamente em frente a uma mesa". No espaço latente dos modelos de difusão de texto para vídeo, essa descrição gera quase sempre a "fusão de identidades" (ou média de traços). Durante as etapas de desruído, as representações dos dois sujeitos se contaminam. Em vez de dois atores nítidos, o modelo gera figuras com feições híbridas ou personagens cujas roupas e cabelos se misturam a cada segundo.
A raiz desse problema está em como os mecanismos de atenção cruzada (cross-attention) interpretam atributos de múltiplos sujeitos sem caixas delimitadoras espaciais estritas. Quando um único prompt fornece ao mesmo tempo "cabelo do personagem A", "vestido da personagem B", maxilar masculino e traços femininos, os pesos de atenção se espalham por todo o quadro. Assim que os personagens se movimentam ou gesticulam, o mapa de atenção sofre desvios, fazendo com que o terno absorva o tecido do vestido ou o rosto feminino adquira traços masculinos. Em um fluxo de trabalho profissional, esperar que um modelo mantenha duas identidades intactas em uma única tomada contínua não é um caminho seguro.
A solução técnica não consiste em amontoar prompts negativos nem em gerar dezenas de tentativas na sorte, mas em adaptar a decupagem cinematográfica consagrada às ferramentas generativas. Em vez de forçar dois rostos nítidos no mesmo plano, o fluxo de trabalho divide o diálogo em enquadramentos focados em um único ator: um plano mestre de situação, seguido de planos alternados sobre o ombro (OTS) e planos fechados de reação. Ao associar cada nó de geração à identidade de apenas um personagem principal, você isola os pesos de difusão e elimina a contaminação de feições na raiz.
A regra de decupagem em três partes para diálogos com IA: planos sobre o ombro e contraplanos
A decupagem profissional de cenas dramáticas divide qualquer diálogo entre dois atores em quatro enquadramentos fundamentais que se adaptam perfeitamente ao storyboard de IA. O plano 1 é um plano mestre de conjunto (Master Two-Shot) em plano médio ou aberto, que estabelece a posição dos corpos e o eixo espacial sem exigir microexpressões complexas. O plano 2 é o plano sobre o ombro (OTS) focado no personagem B, direcionando o foco e a imagem de referência apenas para o personagem B. O plano 3 espelha esse ângulo em contraplano sobre o ombro focado no personagem A. O plano 4 isola os momentos de tensão com primeiros planos de reação bem fechados.
O truque técnico indispensável para acertar os planos 2 e 3 está em como descrever o ombro fora de foco. Se o prompt disser "as costas e o ombro do personagem A", o modelo de difusão tentará renderizar detalhes faciais na nuca, criando orelhas extras ou cabelos deformados. A abordagem correta é tratá-lo como um obstáculo óptico: over-the-shoulder shot, out-of-focus dark foreground shoulder silhouette in lower corner, sharp focus on [Personagem B]. Ao transformar o primeiro plano em uma silhueta escura desfocada, você ajuda o modelo a focar a atenção no rosto visível do interlocutor em foco.
O plano 4 (primeiro plano de reação) é o grande trunfo das mininovelas verticais para celular. A proporção 9:16 é feita para retratos e gera um impacto emocional enorme na tela do smartphone. Um clipe de dois segundos mostrando o personagem A engolindo em seco ou cerrando os dentes evita sujeitos concorrentes no quadro, favorecendo maior estabilidade e consistência facial. Além disso, na montagem externa, os planos de reação funcionam como peças coringas: permitem aplicar cortes em L e em J no áudio e mascaram pequenas imperfeições de continuidade entre as falas.
| Tipo de plano | Enquadramento e foco | Especificação de prompt | Vinculação de referências |
|---|---|---|---|
| Plano mestre (Master) | Plano médio da cintura para cima, ambos os personagens visíveis frente a frente | Câmera estática, altura dos olhos, iluminação neutra, distância de diálogo | Sem fixar um único personagem; usar imagem de clima ou prompt geral |
| Plano sobre o ombro B (OTS) | Enquadramento OTS, personagem B em foco nítido olhando para a esquerda | Olhar ligeiramente para a esquerda; ombro do personagem A em silhueta desfocada | Conectar apenas o nó de referência multiângulo do personagem B |
| Contraplano sobre o ombro A | Enquadramento inverso OTS, personagem A em foco nítido olhando para a direita | Olhar ligeiramente para a direita; ombro do personagem B em silhueta desfocada | Conectar apenas o nó de referência multiângulo do personagem A |
| Primeiro plano de reação | Plano fechado de um único ator reagindo no formato vertical 9:16 | Microexpressão sutil de escuta, câmera estática ou aproximação dolly lenta | Nó de referência de um único ator junto a quadro-chave de alta resolução |
Baseado na vinculação de nós da Say Action e na técnica clássica de plano e contraplano; verificado para vídeo vertical 9:16.
Construção de nós de personagem independentes no canvas da Say Action
Aplicar esse fluxo de diálogo no canvas infinito da Say Action exige uma estrutura de nós bem organizada. Primeiro, crie dois nós de referência de personagem separados no espaço de trabalho: um para o personagem A e outro para o personagem B. Cada nó deve conter âncoras visuais aprovadas, como um retrato frontal neutro (0°) e um ângulo de três quartos (45°) mostrando cabelo e estrutura facial. Essas imagens podem ser geradas antes no próprio canvas usando nós de imagem (como Nano Banana) ou enviando artes conceituais autorizadas. Manter as referências em nós separados garante que os dados visuais não se misturem antes de renderizar os clipes.
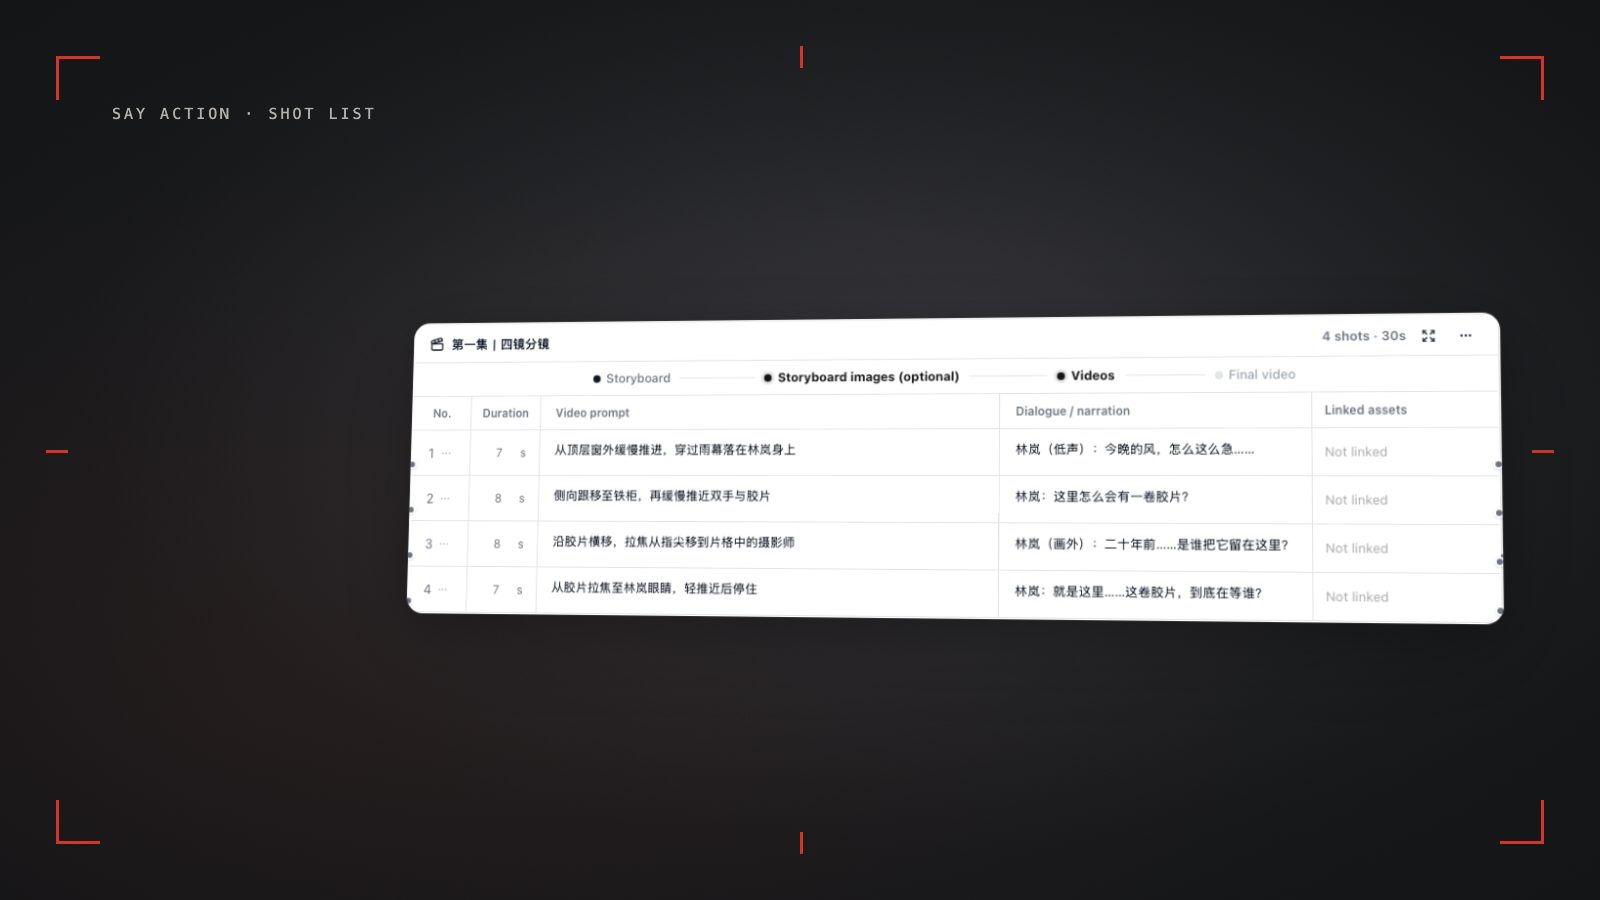
Em seguida, converta o texto em uma tabela de storyboard editável usando o nó de roteiro. Divida a cena em linhas alternadas de acordo com o plano de quatro tomadas. Ao gerar o vídeo da linha 2 (plano 2: OTS focado no personagem B), puxe uma linha de conexão apenas do nó de referência do personagem B para a entrada do nó de vídeo, escolhendo um modelo como Seedance 2.5 ou MiniMax H3. Para a linha 3 (plano 3: contraplano focado no personagem A), conecte apenas o nó do personagem A. Mantenha os clipes curtos, entre 2 e 4 segundos. Essa modularidade reduz distorções ao longo do tempo e dá controle total sobre olhares e reações.
Essa arquitetura desacoplada no canvas garante segurança nas iterações e previsibilidade orçamentária. Se o plano 3 apresentar um movimento de cabeça não natural, basta ajustar o prompt de movimento daquele nó específico e gerá-lo novamente, sem mexer nos planos 1, 2 ou 4 já aprovados. O consumo de créditos é calculado por tomada com base na resolução e duração, exibindo a estimativa antes do envio. O faturamento da plataforma e as garantias de reembolso seguem os limites oficiais do produto: Quando o provedor confirma a falha da geração, os créditos reservados são devolvidos. Se uma interrupção de conexão deixar o resultado ou a cobrança incertos, a tarefa fica aguardando análise para evitar uma liquidação duplicada. Consulte os modelos, as resoluções e a estimativa de créditos na tela de criação. O débito final é mostrado antes de iniciar a geração. A taxa de serviço cobre o espaço de trabalho, não o uso dos modelos. As cobranças da API do provedor são separadas.
A regra dos 180 graus em storyboards verticais 9:16: fixando as linhas de olhar
No cinema tradicional em tela horizontal, cruzar o eixo imaginário de 180 graus causa desorientação espacial; no vídeo vertical 9:16, esse erro é ainda mais prejudicial. Como a tela do celular é estreita, os personagens ficam muito próximos no enquadramento e o público depende da linha do olhar para entender quem está falando com quem. Se no plano 2 o personagem A olha para a direita e no plano 3 o personagem B também olha para a direita, a ilusão de diálogo desmorona: o cérebro interpreta que ambos estão olhando para o mesmo lado, e não um para o outro.
Para manter as linhas de olhar consistentes entre os planos gerados, defina a direção dos olhos em cada linha do storyboard. Estabeleça a linha imaginária em um lado da conversa e mantenha todas as câmeras no mesmo semicírculo. Na tabela da Say Action, padronize a sintaxe: para o personagem A, use eye level, facing screen-right, gaze directed slightly right of camera toward off-screen listener; para o personagem B, use eye level, facing screen-left, gaze directed slightly left of camera toward off-screen speaker. Indicar o olhar levemente fora da lente, em vez de um perfil a 90 graus, mantém as expressões visíveis na tela sem quebrar a geometria do diálogo.
Tão importante quanto a linha do olhar é a disciplina no movimento da câmera. Em cenas de ação, movimentos bruscos podem impressionar, mas no diálogo uma câmera virtual desgovernada destrói as referências espaciais. Evite termos como "câmera em órbita" ou "panorâmica rápida" em planos OTS, pois os modelos de difusão costumam inverter a lateralidade do enquadramento no meio do trajeto. Mantenha movimentos sóbrios: câmera estática em tripé (locked-off tripod shot) ou uma aproximação lenta e sutil (slow subtle dolly-in, 0.5x speed) que valorize a tensão sem deslocar o eixo.
Exportação de clipes e sincronização de diálogos em editores externos
Quando todos os planos de diálogo estiverem gerados no canvas da Say Action, a transição para a pós-produção exige uma organização clara dos arquivos. Aproveite os recursos de salvamento local da Say Action para descarregar os clipes MP4 diretamente em uma pasta estruturada no seu computador. Adote um padrão rigoroso de nomenclatura: Scene03_Shot01_Master, Scene03_Shot02_OTS_CharB, Scene03_Shot03_Reverse_CharA e Scene03_Shot04_Reaction_CharA. Essa padronização permite importar a sequência em softwares como CapCut, Premiere ou DaVinci Resolve sem perder arquivos de mídia nem trocar planos por engano.
Na linha do tempo de edição, monte o diálogo utilizando cortes em J e em L no áudio. Em vez de cortar som e imagem no mesmo ponto de forma brusca, deixe a voz do personagem A começar meio segundo antes de mostrar seu rosto, ou deixe a fala ecoar sobre o plano de reação do personagem B. No formato de mininovelas verticais, um ritmo ágil com cortes a cada 1,5 ou 3 segundos mantém a retenção da audiência alta. Os planos de reação são a salvação do editor: se o clipe de IA apresentar um pequeno tremor labial no fim da frase, corte a imagem para a reação de quem escuta enquanto o áudio termina perfeitamente na trilha sonora.
Por fim, separe a geração visual da sincronização labial definitiva. A Say Action é especializada na decupagem de roteiros, organização de storyboards, quadros-chave e renderização de vídeo multimodelos; a finalização das vozes é concluída na montagem por meio de trilhas de áudio gravadas, dublagens ou ferramentas dedicadas de sincronização labial. Se a edição notar que um plano específico perdeu a intensidade ou que o olhar desviou, não é preciso descartar a cena: volte ao nó correspondente na Say Action, ajuste o prompt, gere um clipe substituto e encaixe-o diretamente na linha do tempo existente.
Conecte suas APIs e serviços de intermediação
Nas configurações do canal, informe a Base URL e a chave API. Defina o protocolo, os IDs dos modelos e os cabeçalhos conforme a documentação do provedor. Confira os modos de imagem e vídeo antes de gerar. Endereços, resoluções e entradas de quadro inicial e final dependem do canal conectado. Solicitar a adaptação de um canal não garante sua compatibilidade.
O BYOK permite configurar o endereço da API, a chave do modelo e cabeçalhos personalizados. Ao usar OneAPI, NewAPI ou outro intermediário, selecione o protocolo OpenAI, Gemini ou Claude correspondente à API e confira os IDs dos modelos e o suporte às APIs de imagem e vídeo. Nem todo serviço ou protocolo privado funciona automaticamente. Chamadas BYOK não têm acréscimo da plataforma sobre o custo dos modelos nem descontam créditos de geração da plataforma; o espaço de trabalho e o uso do provedor são cobrados separadamente.
Conecte apenas provedores de confiança e use HTTPS em produção. As solicitações passam pelo backend autenticado e utilizam os prompts, as referências e as credenciais necessários. Não coloque chaves API, senhas ou cabeçalhos com segredos em canvases públicos, capturas de tela ou pedidos de suporte.
Perguntas frequentes
Posso gerar duas pessoas conversando continuamente em um único clipe de 15 segundos?
Não é recomendado. Gerar dois personagens interagindo em uma única tomada longa provoca graves distorções faciais e mistura de identidades. O padrão profissional consiste em dividir o diálogo em planos de 2 a 4 segundos de um único ator (plano e contraplano) e montá-los em um editor externo.
Como evitar que o ombro desfocado em um plano OTS se deforme ou crie membros extras?
Descreva a figura em primeiro plano no prompt estritamente como um elemento óptico, como "blurred dark foreground shoulder out of focus in corner". Tratar o primeiro plano como uma silhueta escura e borrada impede que o modelo tente renderizar feições ou partes do corpo sobre ele.
O que fazer se a IA inverter a direção do olhar entre os planos?
Especifique a direção exata do olhar na coluna de prompts da tabela de storyboard (por exemplo, "eye level, facing screen-right toward conversational partner"). Se uma tomada sair com o olhar invertido, regenere apenas aquele nó de vídeo isolado no canvas, sem mexer no restante.
A Say Action faz sincronização labial automática com as falas dos personagens?
A Say Action é focada na decupagem de roteiros, organização de storyboards, quadros-chave e geração de vídeo com múltiplos modelos. A sincronização labial e vocal final é realizada exportando os clipes para um editor de vídeo (como CapCut ou Premiere) junto com as faixas de áudio ou usando ferramentas dedicadas de lip-sync.
Posso conectar OneAPI, NewAPI e cabeçalhos personalizados?
O BYOK permite configurar o endereço da API, a chave do modelo e cabeçalhos personalizados. Ao usar OneAPI, NewAPI ou outro intermediário, selecione o protocolo OpenAI, Gemini ou Claude correspondente à API e confira os IDs dos modelos e o suporte às APIs de imagem e vídeo. Nem todo serviço ou protocolo privado funciona automaticamente. Chamadas BYOK não têm acréscimo da plataforma sobre o custo dos modelos nem descontam créditos de geração da plataforma; o espaço de trabalho e o uso do provedor são cobrados separadamente.